Rak pemecut 96 cip menjadi teras kepada langkah Microsoft seterusnya dalam AI
Microsoft memperkenalkan Maia 300, pemecut AI yang ciplet pengkomputerannya akan menggunakan proses N2P Taiwan Semiconductor Manufacturing Co., dengan penggunaan dalam operasi pengeluaran bermula pada 2027. Pengumuman itu memperincikan reka bentuk di sebalik hasrat Microsoft untuk menjadikan perkakasan Maia sendiri sebagai sistem utama bagi menjalankan inferens AI merentas produk dan perkhidmatannya.
Kandungan
- Rak pemecut 96 cip menjadi teras kepada langkah Microsoft seterusnya dalam AI
- Apa yang akan dihasilkan menggunakan TSMC N2P
- Mengapa memori sama penting dengan kuasa pengkomputeran
- Perisian menentukan hala tuju data
- Daripada satu rak kepada 12,288 pemecut
- Apakah yang sebenarnya dibandingkan dalam dakwaan kecekapan
- Penyejukan dan bekalan elektrik membentuk penggunaan
- Maia 200 menjadi titik permulaan
- Peranan lebih besar untuk TSMC dan industri pelayan Taiwan
- Nvidia kekal sebahagian daripada rancangan
- Perkara Utama
Rak yang dirancang itu menggabungkan 96 pemecut dalam had kuasa 167 kilowatt, dengan memori jalur lebar tinggi sebanyak 27.6 terabait dan lebar jalur memori agregat kira-kira 1.7 petabait sesaat. Microsoft menjangkakan Maia 300 menghasilkan 40% lebih banyak token bagi setiap megawatt berbanding sistem terkemuka berasaskan unit pemprosesan grafik, atau GPU, dan sehingga tujuh kali ganda output rak Maia 200.
Angka itu ialah dakwaan prestasi syarikat, bukannya hasil penanda aras bebas. Namun, angka tersebut menunjukkan hala tuju pelaburan Microsoft: meningkatkan jumlah output AI yang berguna dalam had bekalan elektrik, penyejukan dan ruang pusat data, bukan sekadar meningkatkan kuasa pengkomputeran cip individu.
Scott Guthrie, naib presiden eksekutif Cloud + AI Microsoft, menggariskan rancangan penggunaan itu dalam pengumuman Azure Maia syarikat pada 12 Oktober 2026.
Kami akan memperluas keluarga Azure Maia kami kepada penggunaan berskala berbilang gigawatt bermula pada 2027, sekali gus menjadikan Maia sistem inferens utama untuk produk dan perkhidmatan Microsoft.
Komitmen itu merangkumi keluarga Maia, bukan Maia 300 sahaja. Laporan bahawa Microsoft mungkin menggunakan lebih sejuta cip Maia 300 pada 2027 melangkaui pengumuman yang diterbitkan, yang mengesahkan tahun permulaan tetapi tidak menyatakan jumlah cip atau tarikh akhir untuk menyelesaikan peluasan lebih luas itu.
Apa yang akan dihasilkan menggunakan TSMC N2P
Pengesahan Microsoft lebih khusus berbanding gambaran umum bahawa Maia 300 ialah cip 2 nanometer. Ciplet pengkomputerannya menggunakan N2P, iaitu proses dalam keluarga 2 nanometer TSMC. Pengawal memori serta fungsi input dan output diletakkan pada acuan berasingan, membolehkan bahagian berlainan dalam pakej itu menggunakan teknologi pembuatan yang sesuai dengan tugas masing-masing.
Ciplet ialah cebisan silikon yang lebih kecil dan berfungsi bersama acuan lain di dalam satu pakej. Dalam Maia 300, pembahagian ini membolehkan Microsoft meletakkan fungsi pengkomputeran pada proses canggih, sambil menetapkan kesalinghubungan, kawalan memori dan kos sebagai pilihan reka bentuk yang berasingan. Ini tidak bermakna setiap acuan dalam pakej itu menggunakan N2P.
Analisis seni bina Maia 300 Microsoft pada 12 Oktober, yang ditulis oleh Rani Borkar, presiden Sistem Perkakasan dan Infrastruktur Azure, serta Saurabh Dighe, naib presiden korporat Perancangan dan Seni Bina Sistem, menghuraikan pembahagian itu secara jelas.
Dokumen itu menyatakan perubahan seni bina meningkatkan kadar pemprosesan pengkomputeran sistem, yang diukur dalam operasi titik terapung, sebanyak 36%, menyediakan 2.5 kali lebar jalur HBM dan menambah 14% lagi lebar jalur komunikasi antara pemecut. Angka ini merujuk kepada sumber berlainan dalam sistem. Tiada satu pun angka itu, secara bersendirian, menjelaskan dakwaan peningkatan tujuh kali ganda dalam output token rak.
Mengapa memori sama penting dengan kuasa pengkomputeran
Maia 300 direka terutamanya untuk inferens, iaitu proses menggunakan model yang sudah dilatih untuk menjana jawapan atau melaksanakan tugas. Beban kerja yang disasarkan termasuk penaakulan terhadap dokumen panjang, perbualan yang memerlukan respons pantas dan ejen AI yang melaksanakan beberapa langkah serta menggunakan alat dalam tempoh panjang.
Beban kerja sedemikian boleh menghabiskan banyak masa untuk memindahkan data model dan maklumat perbualan yang disimpan, bukannya melakukan pengiraan. Oleh itu, Microsoft membina setiap pemecut berasaskan lapan tindanan memori HBM4 yang menyediakan kapasiti 288 gigabait dan lebar jalur puncak 18 terabait sesaat dalam had kuasa reka bentuk terma 950 watt. Kuasa reka bentuk terma ialah spesifikasi reka bentuk untuk kuasa dan penyejukan, bukannya ukuran penggunaan elektrik berterusan.
Berbanding Maia 200, Microsoft menyatakan Maia 300 menyediakan kapasiti memori 33% lebih besar dan lebar jalur memori 2.5 kali ganda. Perbandingan kapasiti itu selaras dengan peningkatan yang dilaporkan, daripada 216 gigabait kepada 288 gigabait, iaitu pertambahan 72 gigabait bagi setiap pemecut.
Unit lebar jalur perlu diteliti. Sesetengah laporan menyatakan lebar jalur cip terdahulu dalam terabit sesaat dan lebar jalur rak baharu dalam petabit sesaat. Dokumentasi Maia 300 Microsoft menggunakan terabait dan petabait sesaat. Bit dan bait berbeza dengan faktor lapan, maka angka yang dinyatakan menggunakan unit berbeza itu tidak boleh dianggap setara.
Perisian menentukan hala tuju data
Maia 300 mengembangkan Software Defined Locally Accessed Dataflow Architecture, atau SDLA, milik Microsoft. Secara praktikal, pendekatan ini memberi perisian kawalan jelas tentang lokasi penyimpanan data, cara data bergerak, masa formatnya berubah dan cara operasi diselaraskan merentas enjin pengkomputeran, memori dan rangkaian.
Reka bentuk baharu ini menggunakan susunan memori tidak seragam merentas ciplet. Sesetengah memori lebih dekat dengan kawasan pengkomputeran tertentu berbanding memori lain, jadi perisian boleh mengurangkan pemindahan data dengan meletakkan data berhampiran enjin yang memerlukannya. SRAM, iaitu memori pantas yang terletak pada acuan, turut berfungsi sebagai ruang kerja sementara yang diuruskan perisian, sekali gus mengurangkan keperluan terhadap HBM.
Microsoft menggabungkan perubahan itu dengan sokongan lebih luas untuk format angka padat, termasuk MXFP4 dan format storan yang menggunakan kurang daripada tiga bit. Perwakilan ini mengurangkan ruang yang digunakan data dalam memori serta jumlah bait yang perlu dipindahkan semasa inferens. Kegunaannya bergantung pada sokongan perisian dan model, bukan semata-mata format yang lebih kecil.
Reka bentuk itu turut menyasarkan cache KV, yang menyimpan maklumat daripada token yang sudah diproses oleh model supaya maklumat itu tidak perlu dikira semula pada setiap langkah. Mengekalkan cache ini dalam saiz padat penting apabila perbualan menjadi lebih panjang atau ramai pengguna memerlukan perkhidmatan pada masa yang sama.
Ketua Pegawai Eksekutif Microsoft AI, Mustafa Suleyman, mengaitkan program perkakasan itu dengan pembangunan model syarikat dan menjelaskan sebab pasukannya mahu mengawal platform yang menjadi asas model mereka.
Pada skala itu, kami memerlukan platform yang kami miliki dan reka bentuk bersama model kami. Sebab itulah menjalankan model Microsoft AI kami pada cip Maia menjadi tumpuan penting bagi pasukan kami.
Daripada satu rak kepada 12,288 pemecut
Rak Maia 300 mengandungi 24 dulang, setiap satunya membawa empat pemecut serta pemproses hos, memori, storan dan sistem penyejukan yang berkaitan. Jumlah ini menggandakan bilangan pemecut berbanding 48 dalam rak Maia 200. Penyepaduan peralatan hos ke dalam dulang tersebut menghapuskan keperluan untuk dulang hos berasingan dan memberi ruang kepada pemecut tambahan.
Reka bentuk rangkaian Microsoft boleh menghubungkan sehingga 128 rak menjadi superpod yang mengandungi 12,288 pemecut. Reka bentuk itu menggunakan sambungan elektrik dalam rak dan sambungan optik antara rak, dengan pengangkutan AI tersuai yang berasaskan Ethernet.
Rangkaian itu menyediakan satu model komunikasi kepada perisian merentas superpod. Pemecut boleh memulakan pemindahan kepada pemecut lain tanpa menghalakannya melalui pemproses hos atau antara muka rangkaian berasingan untuk komunikasi antara rak.
Ini penting apabila model dibahagikan kepada beberapa cip. Keselarian tensor membahagikan sebahagian pengiraan model merentas pemecut dan memerlukan komunikasi kerap antara pemecut tersebut. Microsoft menyatakan perisian boleh mengekalkan trafik yang memerlukan masa respons paling singkat dalam satu rak, sambil mengagihkan kerja lain dengan lebih meluas.
Rangkaian yang sama boleh memisahkan pemprosesan awal prompt daripada penjanaan jawapan seterusnya. Data KV yang disimpan dipindahkan terus antara pekerja yang mengendalikan peringkat tersebut. Pemecut lebihan di rak lain juga boleh mengambil alih apabila kapasiti tidak tersedia, walaupun laluan komunikasi yang lebih panjang menambah kependaman.
Apakah yang sebenarnya dibandingkan dalam dakwaan kecekapan
Microsoft memberikan dua perbandingan utama yang perlu dibezakan. Jangkaan peningkatan 40% dari segi token bagi setiap megawatt membandingkan Maia 300 dengan sistem GPU terkemuka. Dakwaan output token sehingga tujuh kali ganda bagi setiap rak membandingkan rak Maia 300 yang dikonfigurasi sepenuhnya dengan Maia 200.
Token ialah unit teks yang diproses oleh model bahasa, lazimnya cebisan perkataan dan bukannya perkataan penuh. Kadar pemprosesan token mengukur jumlah output, tetapi tidak dengan sendirinya membuktikan kualiti jawapan, kelajuan respons bagi setiap pengguna atau prestasi pada semua model.
Dokumen seni bina itu juga menggunakan istilah yang berbeza untuk kecekapan berbanding Maia 200. Huraian rak menyatakan prestasi sehingga 2.5 kali ganda lebih tinggi bagi setiap watt, manakala perbandingan pada bahagian kesimpulan menyatakan lebih daripada 2.5 kali ganda. Tanpa syarat ujian terperinci, huraian tersebut tidak wajar diringkaskan sebagai satu hasil yang dijamin.
Bilangan pemecut menjelaskan sebahagian daripada peningkatan output rak: Maia 300 menggandakan jumlah cip. Oleh itu, dakwaan kadar pemprosesan tujuh kali ganda melangkaui ketumpatan semata-mata dan menggabungkan pemecut tambahan dengan perubahan pada memori, perisian, rangkaian dan kecekapan pelaksanaan. Dakwaan itu tidak patut ditafsirkan sebagai peningkatan tujuh kali ganda bagi setiap cip individu.
Spesifikasi pemecut 950 watt juga berbeza daripada had kuasa rak 167 kilowatt. Mendarabkan 96 dengan 950 watt memberikan 91.2 kilowatt. Angka rak merangkumi sistem yang lebih luas, termasuk hos, memori, rangkaian dan penyaluran kuasa, maka kedua-dua nilai itu merujuk kepada sempadan sistem yang berlainan.
Penyejukan dan bekalan elektrik membentuk penggunaan
Pada 167 kilowatt bagi setiap rak, Maia 300 memerlukan pendekatan bersepadu terhadap kuasa dan haba. Microsoft menyatakan penyejukan cecair mengeluarkan lebih daripada 80% beban haba rak daripada pemecut, pengatur voltan dan cip suis rangkaian. Penyejukan udara mengendalikan memori, storan dan komponen lain.
Rak itu boleh disambungkan terus kepada bekalan air kemudahan jika tersedia, atau menggunakan penukar haba di pusat data yang bergantung pada penyejukan udara. Dua suapan kuasa dan suis pemindahan automatik menyokong operasi berterusan apabila satu suapan dimatikan untuk penyelenggaraan.
Pengukuran kuasa pada peringkat rak dan barisan disalurkan kepada operasi pusat data. Microsoft menyatakan maklumat itu membantu algoritmanya memperuntukkan kuasa, menempatkan beban kerja dan melaraskan ketumpatan penggunaan agar sepadan dengan kapasiti elektrik dan penyejukan yang tersedia.
Alistair Speirs, pengurus besar Microsoft, menjelaskan kaitan dengan kos operasi ketika membincangkan seni bina baharu itu.
Kami memerlukan seni bina baharu yang pada asasnya memberikan prestasi lebih baik dan penggunaan kuasa yang kami miliki dengan lebih cekap.
Oleh itu, sasaran penggunaan berskala gigawatt bukan sekadar rancangan pembelian cip. Ia menggambarkan komitmen infrastruktur berskala besar yang melibatkan rak, rangkaian, kapasiti elektrik dan penyejukan. Pengumuman yang diterbitkan tidak menyatakan lokasi, agihan serantau atau jadual penyiapan kapasiti itu.
Maia 200 menjadi titik permulaan
Microsoft menyatakan Maia 200 sudah mengendalikan beban kerja pengeluaran, termasuk Microsoft Copilot, dan menyokong pasukan MAI dalam membangunkan model baharu. Ia menjalankan model OpenAI, model MAI milik Microsoft dan keluarga model sumber terbuka terkemuka, dengan penggunaan di Amerika Syarikat, Eropah dan Australia.
Laporan berbeza tentang pelaksanaan GitHub Copilot dan Microsoft Foundry. Satu laporan menyatakan kedua-duanya sudah mengendalikan beban kerja pengeluaran pada Maia 200. Kenyataan Microsoft pada 12 Oktober pula menyatakan kedua-duanya dijangka menyusul menjelang akhir 2026. Jadual rasmi itu menjadi asas yang lebih kukuh untuk menerangkan statusnya.
Microsoft melaporkan sehingga 1.7 kali ganda lebih banyak token bagi setiap watt untuk fungsi AI terbina dalam pengalaman Teams, Copilot dan Cowork berbanding infrastruktur GPU terkemuka. Microsoft turut menyenaraikan kegunaan masa depan merangkumi bantuan pengekodan, perkhidmatan model awan, inferens dan penjanaan data untuk MAI, serta aliran kerja klinikal melalui Dragon Copilot.
Urutan pengumuman dan pencapaian yang dirancang adalah seperti berikut:
- 2023: Microsoft memperkenalkan Maia 100, pemecut AI tersuai pertamanya.
- Januari 2026: Microsoft mengumumkan Maia 200.
- 12 Oktober 2026: Microsoft memperkenalkan seni bina Maia 300 dan mengesahkan beban kerja pengeluaran Maia 200.
- Menjelang akhir 2026: GitHub Copilot dan Microsoft Foundry dijangka turut beralih kepada Maia 200.
- 2027: Penggunaan Maia 300 dalam operasi pengeluaran dan peluasan keluarga Maia ke arah skala berbilang gigawatt bermula.
Jim Kleewein, felo teknikal Microsoft, menyatakan sebahagian ciri Microsoft 365 Copilot sepatutnya menjadi lebih pantas dengan Maia 300. Tiada peningkatan kuantitatif dalam masa respons pengguna diumumkan.
Peranan lebih besar untuk TSMC dan industri pelayan Taiwan
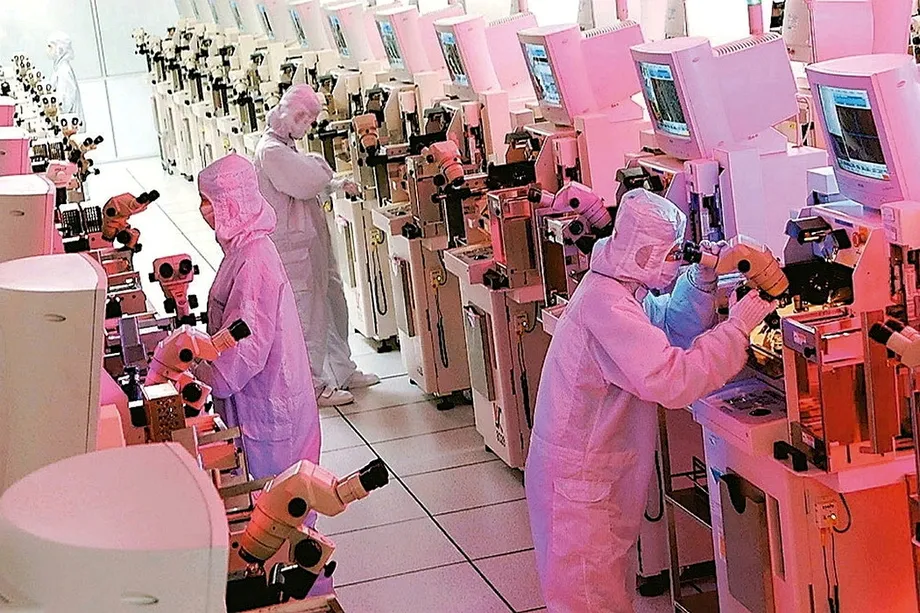
Maia 300 mengesahkan peranan TSMC dalam perkakasan AI canggih sebuah lagi syarikat awan utama. Microsoft mereka bentuk pemecut itu, manakala TSMC mengeluarkan ciplet pengkomputerannya menggunakan N2P. Oleh itu, mengurangkan pergantungan pada GPU yang dibeli tidak menghapuskan pergantungan terhadap kapasiti pembuatan semikonduktor.
TSMC menyatakan lima kemudahan yang menggunakan proses 2 nanometernya akan meningkatkan pengeluaran sepanjang 2026, dengan dua di Hsinchu dan tiga di Kaohsiung. Pengeluaran volum N2P dijadualkan pada separuh kedua 2026, sebelum penggunaan Microsoft yang dirancang pada 2027.
Anggaran pasaran meletakkan kapasiti bulanan 2 nanometer TSMC pada kira-kira 90,000 hingga 100,000 wafer menjelang akhir 2026 dan melebihi 110,000 menjelang pertengahan 2027. Anggaran bahawa proses itu boleh menyumbang hampir 10% hasil pada separuh kedua tahun ialah ramalan, bukannya hasil yang disahkan daripada pesanan Maia.
Sasaran yang dinyatakan TSMC termasuk pengeluaran wafer 45% lebih tinggi pada tahun pertama proses 2 nanometernya berbanding tahun pertama pengeluaran 3 nanometer pada 2023, serta kadar pertumbuhan tahunan terkumpul kapasiti 2 nanometer sebanyak 70% antara 2026 dan 2028. Kedua-dua sasaran itu tidak menentukan bahagian output yang akan diperoleh Microsoft.
Ramalan pasaran yang lebih luas mengenal pasti Foxconn, Quanta, Wistron, Wiwynn, Pegatron, Inventec, Compal dan MiTAC sebagai bakal penerima manfaat daripada peningkatan permintaan pelayan AI. Ramalan meletakkan penghantaran pelayan AI pada 3.5 juta unit pada 2026 dan 5.2 juta unit pada 2027. Jumlah yang dibundarkan itu membayangkan pertumbuhan kira-kira 49%, sedikit melebihi ramalan 46% yang disebut secara berasingan.
Ramalan turut menjangkakan perbelanjaan modal penyedia awan utama Amerika Syarikat meningkat 96% pada 2026, dengan kira-kira separuh daripada peningkatan itu datang daripada pembinaan pusat data. Foxconn menjangkakan penghantaran rak AI tahunannya meningkat lebih dua kali ganda, manakala Quanta mengekalkan sasaran pertumbuhan pelayan AI sekurang-kurangnya 100%. Ini ialah jangkaan industri yang lebih luas, bukannya pengesahan kontrak bekalan Maia 300.
Nvidia kekal sebahagian daripada rancangan
Matlamat Microsoft ialah menjadikan Maia sistem inferens utama bagi produk dan perkhidmatannya sendiri, bukannya menggantikan setiap GPU di seluruh Azure. Latihan model baharu kekal sebagai keperluan berasingan, dan Microsoft terus bekerjasama dengan Nvidia dan AMD untuk tujuan itu.
Dalam panggilan laporan pendapatan Julai, Microsoft menyatakan ia menjangkakan menjadi antara penyedia awan terawal menggunakan sistem Nvidia Vera Rubin dan AMD Helios. Evercore ISI menganggarkan Maia boleh merangkumi kira-kira 10% perbelanjaan cip AI Microsoft menjelang suku pertama 2027. Bahagian perbelanjaan berbeza daripada bahagian kerja inferens yang dilaksanakan, maka anggaran itu tidak mengukur secara langsung kemajuan ke arah matlamat operasi Microsoft.
Pemecut Maia ketika ini tidak tersedia untuk disewa mengikut jam oleh syarikat lain. Keadaan itu mengehadkan penilaian pihak luar dan bermakna dakwaan prestasi yang diterbitkan tidak membuktikan hasil yang akan dicapai pelanggan bebas dengan model tertentu.
Perkara yang masih belum pasti termasuk jumlah penggunaan, masa untuk mencapai kapasiti penuh gigawatt, syarat penanda aras terperinci dan pembahagian beban kerja akhirnya antara Maia dengan GPU yang dibeli. Microsoft menyatakan ia akan berkongsi lebih banyak maklumat strategi di Ignite 2026 di San Francisco dan dalam talian pada November.
Perkara Utama
- Ciplet pengkomputeran Maia 300 menggunakan TSMC N2P, dengan penggunaan dalam operasi pengeluaran bermula pada 2027.
- Setiap pemecut mempunyai memori HBM4 sebanyak 288 GB dan lebar jalur memori puncak 18 TB/s.
- Satu rak penuh mengandungi 96 pemecut dalam had kuasa 167 kW.
- Microsoft menjangkakan 40% lebih banyak token bagi setiap megawatt berbanding sistem GPU terkemuka dan output rak sehingga tujuh kali ganda daripada Maia 200.
- Penggunaan keluarga Maia akan diperluas ke arah skala berbilang gigawatt bermula pada 2027, tanpa tarikh akhir penyiapan yang diumumkan.
- Laporan tentang penggunaan lebih sejuta Maia 300 tidak disahkan dalam pengumuman Microsoft.
- Microsoft terus merancang penggunaan sistem Nvidia dan AMD bersama perkakasannya sendiri.