Model yang mempelajari huruf RNA dan hubung kaitnya
Penyelidik di Universiti Sains dan Teknologi China telah mengeluarkan structRFM, sebuah model asas RNA terbuka yang dilatih menggunakan 21 juta pasangan jujukan RNA dan struktur yang dianotasi secara komputasi. Keluaran ini merangkumi data latihan berpasangan, pemberat model dan kod sumber, sekali gus menyediakan bahan kepada makmal lain untuk menghasilkan semula kajian itu dan menyesuaikan sistem tersebut.
Kandungan
- Model yang mempelajari huruf RNA dan hubung kaitnya
- Mengapa pelipatan sama penting dengan jujukan
- Bagaimana 21 juta pasangan data latihan dihimpunkan
- Melatih model menggunakan maklumat tersembunyi
- Dapatan ujian struktur
- Daripada pemprosesan RNA kepada pengelasan fungsi
- Manfaat keluaran terbuka untuk penyelidik
- Pasukan dan garis masa penerbitan
- Perubahan hasil kajian terhadap penyelidikan RNA
- Perkara Utama
Kajian yang diterbitkan oleh Nature pada 4 November 2026 itu menerangkan model yang mempelajari kedua-dua susunan blok binaan molekul RNA dan hubungan yang membantu molekul tersebut melipat. Penyesuaiannya untuk meramalkan struktur tiga dimensi, yang dinamakan Zfold, mencapai prestasi yang menurut penulis setanding dengan AlphaFold3 dalam penilaian CASP15-natural, CASP16 dan RNA-Puzzles.
Daya tarikan praktikalnya ialah structRFM hanya memerlukan jujukan RNA sebagai input selepas latihan. Model ini menghasilkan maklumat yang boleh digunakan penyelidik untuk beberapa tugas, termasuk meramalkan struktur molekul, mengenal pasti tapak yang terlibat dalam pemprosesan RNA dan mengelaskan molekul RNA mengikut fungsi.
Kertas penyelidikan structRFM oleh Nature mengetengahkan kajian ini sebagai cara untuk memanfaatkan pengetahuan struktur dalam pelbagai tugas ramalan. Peng Xiong dan S. Kevin Zhou ialah penulis koresponden, manakala Heqin Zhu ialah penulis pertama.
Mengapa pelipatan sama penting dengan jujukan
RNA terlibat dalam penghasilan protein, pengawalan gen dan pemprosesan mesej genetik. Jujukannya ialah susunan nukleotidanya, iaitu unit molekul yang lazimnya diwakili oleh huruf A, U, C dan G. Susunan itu membawa maklumat, manakala cara molekul tersebut melipat membantu menentukan fungsinya.
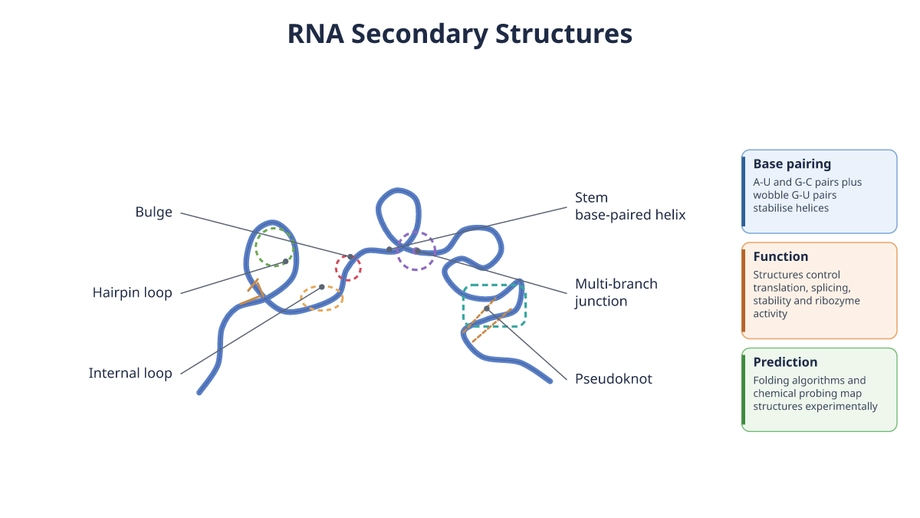
Bahagian tertentu pada satu untaian RNA boleh berpasangan dengan bahagian lain pada untaian yang sama. Hubungan itu membentuk struktur sekunder, iaitu pola kawasan berpasangan, batang dan gelung. Molekul itu kemudian melipat menjadi bentuk tiga dimensi, yang dikenali sebagai struktur tertier dan mempengaruhi aktiviti serta interaksinya dengan molekul lain.
Banyak model bahasa RNA mempelajari pola daripada himpunan jujukan yang besar, sama seperti model bahasa mempelajari hubungan antara perkataan. structRFM menambahkan maklumat tentang nukleotida yang berpasangan semasa latihan, sekali gus membantunya mempelajari hubungan antara kedudukan yang mungkin berjauhan dalam jujukan.
Para penyelidik berusaha mengekalkan fleksibiliti model asas: sistem yang dilatih secara meluas dan ciri yang dipelajarinya boleh disesuaikan untuk pelbagai tujuan. Matlamat mereka adalah untuk memasukkan maklumat pelipatan ke dalam asas bersama itu, bukannya melatih sistem yang hanya berguna untuk satu tugas struktur.
Bagaimana 21 juta pasangan data latihan dihimpunkan
Pasukan itu membina set data yang mengandungi kira-kira 21 juta pasangan jujukan RNA dan struktur sekundernya. Anotasi struktur dijana secara komputasi, membolehkan penyelidik berlatih pada skala yang jauh lebih besar berbanding himpunan yang hanya terdiri daripada struktur yang ditentukan melalui eksperimen makmal.
Ramalan komputer boleh mengandungi kesilapan dan mencerminkan kekuatan serta kelemahan kaedah yang menghasilkannya. Bagi mengurangkan kebergantungan pada satu peramal, penyelidik memperkenalkan MUSES, gabungan struktur sekunder daripada pelbagai sumber. Gabungan ini mengumpulkan maklumat daripada beberapa sumber ramalan dan bukannya bergantung sepenuhnya pada satu sumber.
MUSES menangani masalah utama dalam melatih model menggunakan struktur ramalan: kesilapan berulang dalam anotasi latihan boleh membentuk perkara yang dipelajari model. Penggabungan ramalan struktur dirancang untuk mengurangkan bias peramal sambil mengekalkan maklumat berguna tentang pasangan bes.
Sumber latihan dan penilaian kajian itu menggunakan himpunan biologi yang mantap, termasuk RNAcentral, Rfam dan Protein Data Bank. Pernyataan datanya mengenal pasti keluaran berkaitan, termasuk RNAcentral versi 24.0 serta Rfam versi 14.10 dan 15.0, supaya penyelidik dapat menjejak set data yang digunakan dalam eksperimen.
Melatih model menggunakan maklumat tersembunyi
structRFM menggunakan pemodelan bahasa bertopeng, iaitu kaedah latihan yang menyembunyikan sebahagian input dan melatih model untuk mendapatkan semula maklumat yang hilang daripada konteks sekeliling. Bagi RNA, ini bermaksud mempelajari hubungan antara nukleotida, bukannya perkataan.
Pasukan itu memasukkan pasangan bes dalam proses ini melalui operasi pemadanan pasangan. Nisbah penopengan dinamik mengimbangi latihan berpandukan hubungan struktur dengan penopengan pada kedudukan nukleotida individu. Ini memberi peluang kepada model untuk mempelajari kedua-dua pola jujukan setempat dan hubungan yang berkaitan dengan pelipatan.
Model yang terhasil menyediakan tiga jenis ciri: maklumat tentang jujukan secara keseluruhan, maklumat tentang setiap nukleotida dan maklumat tentang pasangan nukleotida. Ciri ialah perwakilan berangka yang boleh digunakan oleh sistem ramalan lain. Tugas yang berbeza boleh menggunakan tahap perwakilan yang berbeza.
Penyelidik turut menjalankan eksperimen ablasi, iaitu dengan membuang atau mengubah bahagian model untuk menguji sumbangannya. Eksperimen itu menyokong sumbangan maklumat struktur dan strategi penopengan terhadap peningkatan yang dilaporkan, sekali gus memberikan bukti bagi pilihan reka bentuk di sebalik structRFM.
Dapatan ujian struktur
structRFM menunjukkan prestasi kukuh dalam pengelasan homologi tanpa latihan khusus. Homologi merujuk kepada hubungan yang diwarisi daripada asal usul evolusi bersama. Dalam konteks ini, pengelasan tanpa latihan khusus menguji sejauh mana perwakilan yang dipelajari berguna untuk mengenal pasti hubungan sedemikian tanpa latihan khusus menggunakan tugas pengelasan sasaran.
Penulis turut melaporkan peningkatan dalam ramalan struktur sekunder dan prestasi kukuh pada keluarga RNA yang baru dikeluarkan. Keluarga RNA menghimpunkan molekul berkaitan yang mempunyai ciri jujukan atau struktur yang sama. Ujian terhadap keluarga yang baru dikeluarkan menilai sejauh mana model berfungsi di luar kumpulan biasa dalam set data sedia ada.
Bagi ramalan struktur tertier, pasukan itu membangunkan Zfold dengan menyesuaikan ciri yang dipelajari structRFM untuk model yang meramalkan bentuk tiga dimensi. Penulis melaporkan peningkatan pada kedua-dua bentuk yang diramalkan dan struktur sekunder yang diekstrak daripada ramalan tersebut.
Zfold dinilai menggunakan CASP15-natural, CASP16 dan RNA-Puzzles, iaitu himpunan penanda aras untuk menilai ramalan struktur molekul. Dalam penilaian tersebut, kertas kajian itu menyifatkan prestasinya sebagai setanding dengan AlphaFold3. Perbandingan itu merujuk kepada hasil Zfold pada penanda aras yang dinamakan, manakala structRFM menyediakan perwakilan RNA yang menjadi asasnya.
Kajian itu mengetengahkan beberapa jenis kejayaan, bukannya satu skor ketepatan yang merangkumi setiap kegunaan. Mengenal pasti jujukan berkaitan, meramalkan pasangan bes dan membina semula bentuk tiga dimensi ialah masalah yang berbeza, dan setiap satunya memerlukan penilaian tersendiri.
Daripada pemprosesan RNA kepada pengelasan fungsi
structRFM turut diuji pada tugas yang berkaitan dengan fungsi RNA. Ini termasuk ramalan tapak penyambungan, pengenalpastian tapak kemasukan ribosom dalaman dan pengelasan RNA bukan pengekod, sekali gus meluaskan penilaian di luar bentuk molekul.
Tapak penyambungan menandakan sempadan yang digunakan semasa sel memproses mesej RNA. Semasa penyambungan, bahagian terpilih dibuang dan bahagian yang tinggal dicantumkan. Ramalan sempadan ini membantu penyelidik mengkaji cara mesej genetik disusun sebelum digunakan untuk menghasilkan protein.
Tapak kemasukan ribosom dalaman, atau elemen IRES, ialah kawasan RNA yang membolehkan jentera sel yang bertanggungjawab menghasilkan protein memulakan translasi dari bahagian dalaman. Pengenalpastiannya memerlukan pengecaman pola fungsi dalam sesuatu jujukan, menjadikan tugas ini satu lagi ujian terhadap maklumat yang ditangkap semasa pralatihan.
RNA bukan pengekod menjalankan fungsi selain menjadi templat untuk penghasilan protein. Pengelasannya bermaksud mengumpulkan molekul ke dalam kumpulan yang berkaitan. Penulis melaporkan peningkatan prestasi merentas tugas fungsi ini, menunjukkan bahawa perwakilan yang dipelajari kekal berguna apabila sasaran ramalan berubah daripada struktur kepada peranan biologi.
Pasukan itu turut memperluas model untuk pengelasan RNA bukan pengekod panjang menggunakan strategi pembahagian segmen. Membahagikan jujukan panjang kepada beberapa bahagian membolehkan model digunakan pada input yang sukar diproses sebagai satu unit tunggal.
Manfaat keluaran terbuka untuk penyelidik
Keluaran ini merangkumi tiga sumber dengan kegunaan yang berbeza. Set data menyediakan contoh yang digunakan untuk pembelajaran. Pemberat model mengandungi nilai berangka yang dipelajari semasa latihan. Kod sumber menerangkan cara perisian dilaksanakan dan dijalankan.
Akses kepada pemberat membolehkan penyelidik menggunakan model yang telah dilatih tanpa perlu mengulangi keseluruhan proses pralatihan. Akses kepada data dan kod pula menyokong penelitian lebih dekat terhadap prosedur latihan, penghasilan semula eksperimen dan pembangunan pendekatan alternatif.
Kertas kajian itu mengenal pasti repositori projek sebagai heqin-zhu/structRFM di GitHub. Ia turut menyenaraikan arkib Zenodo untuk set data pralatihan dengan DOI 10.5281/zenodo.18272040 dan arkib kod sumber serta titik semak model dengan DOI 10.5281/zenodo.18274292. DOI ialah pengecam kekal yang bertujuan memastikan sumber penyelidikan dapat dijejak dari semasa ke semasa.
Pernyataan data menyebut bahawa set data latihan dan ujian tersedia kepada umum melalui repositori projek. Ia turut menyediakan pecahan IRES yang diproses dan digunakan dalam kajian serta data sumber yang mendasari rajah. Penulis menyatakan bahawa tiada sekatan dikenakan terhadap ketersediaan data.
Butiran tersebut penting untuk perbandingan. Penyelidik boleh menyemak set data dan pembahagian yang digunakan, menjalankan semula penilaian dan menguji sama ada pilihan latihan yang berbeza mengubah hasilnya. Oleh itu, keluaran ini menyokong penelitian terhadap dapatan serta penggunaan semula model.
Pasukan dan garis masa penerbitan
Kerja ini diketuai melalui Sekolah Kejuruteraan Bioperubatan USTC dan makmal Pengimejan Perubatan, Robotik, Pengkomputeran Analitik dan Pembelajaran, yang dikenali sebagai MIRACLE. Penulis menyenaraikan afiliasi di Hefei dan Institut Penyelidikan Lanjutan Suzhou USTC. Pengarang bersama Ruifeng Li berafiliasi dengan Kolej Sains Komputer dan Teknologi Universiti Zhejiang di Hangzhou.
Zhou, seorang profesor, dan Xiong, seorang felo penyelidikan khas, menggagaskan dan menyelia kajian itu. Zhu mereka bentuk dan melaksanakan kerangka tersebut, menjalankan pralatihan serta beberapa eksperimen ramalan struktur dan pengelasan RNA, dan menganalisis hasilnya. Ahli pasukan lain menjalankan ujian homologi, perbandingan set data, pengenalpastian IRES dan penilaian struktur.
Penerbitan dan pengumuman umum kajian ini berlangsung pada dua tarikh kalendar:
- 4 November 2026: Nature menyenaraikan penerbitan An open structure-guided RNA foundation model for generalizable prediction.
- 5 November 2026: Kajian dan keluaran terbukanya diumumkan kepada umum di China, dengan penerbitan dalam talian dilaporkan muncul pada awal pagi.
Penulis melaporkan bahawa kajian ini menerima sokongan daripada Yayasan Sains Semula Jadi Kebangsaan China, Program Penyelidikan dan Pembangunan Utama Kebangsaan, program penyelidikan di Jiangsu dan Suzhou serta Projek Sanming Perubatan di Shenzhen. Mereka mengisytiharkan tiada kepentingan bersaing.
Perubahan hasil kajian terhadap penyelidikan RNA
structRFM menyediakan titik permulaan bersama untuk beberapa kegiatan penyelidikan. Makmal yang mengkaji pemprosesan RNA boleh menyesuaikan model asas yang sama dengan model yang digunakan kumpulan lain untuk mengkaji pelipatan atau mengelaskan molekul bukan pengekod. Setiap aplikasi masih memerlukan pembangunan dan penilaian khusus bagi tugas masing-masing.
Gabungan 21 juta pasangan data latihan, pembelajaran berpandukan struktur dan titik semak yang dikeluarkan memberikan sistem konkrit untuk diteliti oleh penyelidik, bukan sekadar penerangan tentang algoritma. MUSES dan eksperimen penopengan turut menawarkan pilihan reka bentuk khusus yang boleh diuji atau diubah suai oleh pasukan lain.
Dapatan yang dilaporkan tertumpu pada ramalan dan pengelasan komputasi. Usaha ke arah aplikasi bioperubatan memerlukan eksperimen biologi tambahan, termasuk menyemak struktur yang diramalkan dan menguji fungsi yang diberikan kepada molekul RNA tertentu.
Kertas kajian itu tidak menetapkan garis masa bagi aplikasi klinikal. Perubahan serta-merta ialah akses: penyelidik di seluruh dunia boleh mendapatkan sumber latihan, meneliti pelaksanaan dan mengkaji sama ada peningkatan yang dilaporkan turut berlaku pada set data RNA mereka sendiri.
Perkara Utama
- Penyelidik USTC mengeluarkan structRFM, sebuah model asas RNA yang dilatih menggunakan kira-kira 21 juta pasangan jujukan dan struktur sekunder.
- Model ini mempelajari pola jujukan dan hubungan pasangan bes, kemudian menghasilkan ciri hanya dengan input jujukan.
- MUSES menggabungkan sumber ramalan struktur, manakala penopengan dinamik mengimbangi maklumat struktur dan nukleotida semasa latihan.
- Penulis melaporkan prestasi kukuh dalam pengelasan homologi dan peningkatan ramalan struktur sekunder, termasuk ujian pada keluarga RNA yang baru dikeluarkan.
- Zfold, penyesuaiannya untuk ramalan struktur tertier, mencapai prestasi yang disifatkan setanding dengan AlphaFold3 pada tiga himpunan penanda aras yang dinamakan.
- Set data, pemberat model, kod sumber dan sumber penilaian tersedia kepada umum untuk digunakan semula dan menghasilkan semula kajian.