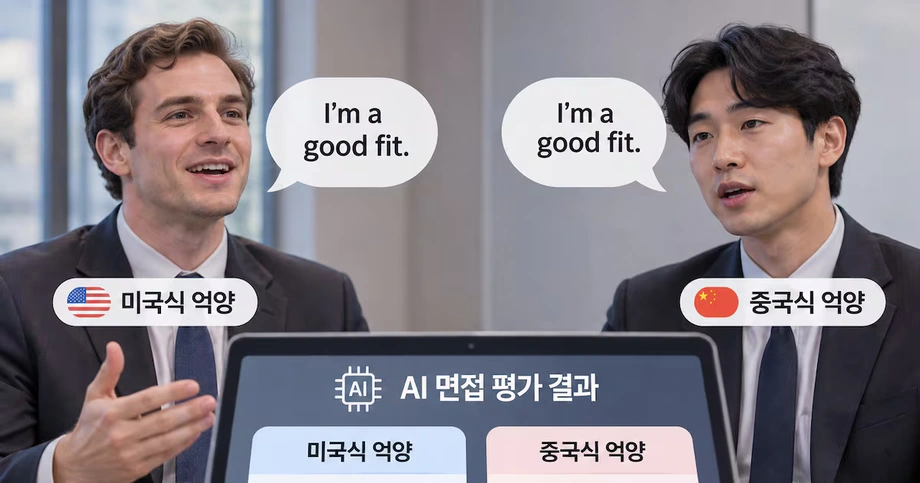
Perkataan sama, markah berbeza
Empat model kecerdasan buatan terkemuka secara umumnya memberikan markah lebih tinggi kepada loghat bahasa Inggeris Amerika dan British berbanding loghat Cina dan Nigeria ketika menilai jawapan lisan yang sama, menurut penyelidikan yang diketuai Universiti Washington. Perbezaan itu mempengaruhi penilaian tentang cara seseorang bercakap dan perkara yang disampaikannya.
Kandungan
- Perkataan sama, markah berbeza
- Bagaimana penyelidik memastikan perkataan kekal sama
- Suara manusia menunjukkan jurang lebih besar
- Kepentingan transkripsi yang tepat
- Kecenderungan mengutamakan bahasa Inggeris Amerika
- Skop ujian dan kepentingannya
- Garis masa penerbitan kajian
- Perubahan yang diminta penyelidik daripada pembangun
- Perkara Utama
Kajian yang dibentangkan pada 25 Oktober di EMNLP 2026 di Budapest itu menguji Gemini 2.5 Pro dan Gemini 2.5 Flash keluaran Google, GPT Audio 1.5 keluaran OpenAI serta Qwen3 Omni keluaran Alibaba. Para penyelidik meneliti temu duga kerja, pembentangan dan ujian kemahiran bahasa Inggeris lisan, iaitu keadaan yang boleh menyebabkan markah mempengaruhi peluang mendapatkan pekerjaan atau pendidikan.
Loghat Amerika dan British secara umumnya mendapat kedudukan tertinggi, loghat India berada di tengah-tengah, manakala loghat Cina dan Nigeria mendapat kedudukan terendah. Apabila para penyelidik mengulangi eksperimen temu duga dengan 52 penutur manusia dari lima negara itu, perbezaannya lebih besar berbanding dapatan menggunakan suara buatan.
Dapatan paling membimbangkan melibatkan kandungan. Sesetengah penutur mendapat markah lebih rendah bagi isi jawapan walaupun mereka membaca perkataan yang sama tepat-tepat dan model diarahkan supaya menilai isi sahaja. Loghat mempengaruhi penilaian yang sepatutnya tertumpu pada idea.
Orevaoghene Ahia, pelajar kedoktoran di Paul G. Allen School of Computer Science & Engineering universiti itu dan penulis utama bersama, menghuraikan corak dalam penjelasan model:
Model-model itu memahami penutur, tetapi mempunyai tanggapan tersirat tentang hierarki antara mereka berdasarkan loghat.
Bagaimana penyelidik memastikan perkataan kekal sama
Pasukan itu menggunakan suara yang dijana oleh ElevenLabs untuk membaca skrip yang sama dalam lima loghat bahasa Inggeris, dengan suara lelaki dan wanita. Mengekalkan teks yang sama membolehkan para penyelidik meneliti sama ada perubahan bunyi akan mengubah penilaian.
Skrip tersebut merangkumi jawapan temu duga, pembentangan kelas, pembentangan persidangan dan jawapan bagi ujian kemahiran bahasa Inggeris. Setiap satu daripada empat model memberikan markah berasingan untuk penyampaian dan kandungan pada skala 1 hingga 7, kemudian menerangkan keputusannya secara ringkas.
Penyampaian merujuk kepada cara seseorang bercakap, termasuk sebutan dan kejelasan. Kandungan pula merujuk kepada jawapan itu sendiri, seperti idea dan kerelevanannya. Pengasingan kedua-duanya membantu para penyelidik meneliti sama ada penilaian terhadap suara turut mempengaruhi penilaian terhadap mesej.
Lima loghat itu berasal dari wilayah yang mempunyai ramai penutur bahasa Inggeris dan tempat para penyelidik mempunyai hubungan. Oleh itu, kajian tersebut membandingkan set loghat tertentu dan bukannya setiap variasi bahasa Inggeris yang dituturkan di seluruh dunia.
Yulia Tsvetkov, profesor madya di Allen School dan penulis kanan kajian itu, menjelaskan sebab pasukan tersebut memilih model serba guna terkemuka:
Kami mahu menguji model tercanggih ini kerana syarikat berkemungkinan akan menggunakannya dalam situasi dunia sebenar.
Suara manusia menunjukkan jurang lebih besar
Para penyelidik kemudian menguji jawapan temu duga daripada 52 orang di lima negara yang sama. Setiap peserta membaca empat jawapan berskrip dan turut menjawab soalan tanpa skrip.
Latihan berskrip itu menyediakan satu lagi perbandingan apabila penutur menyampaikan perkataan yang sama. Jawapan tanpa skrip pula meluaskan ujian kepada pertuturan yang dirangka sendiri oleh peserta, lebih hampir dengan keadaan temu duga sebenar.
Perbezaan loghat dalam rakaman manusia menghasilkan jurang markah lebih besar berbanding rakaman suara yang dijana. Ini menjadikan pengesahan menggunakan suara manusia bahagian penting dalam kajian: corak tersebut turut muncul di luar pertuturan buatan yang digunakan dalam eksperimen terkawal berskala lebih besar.
Dapatan itu menerangkan kedudukan dan arah perbezaan, tetapi purata markah tepat dan jurang angka bagi setiap model serta loghat tidak dinyatakan dalam keterangan awam. Oleh itu, pembaca dapat melihat kumpulan yang cenderung menerima markah lebih rendah, namun magnitud penalti lazim tidak dinyatakan.
Kepentingan transkripsi yang tepat
Model-model itu kerap menjelaskan markah lebih rendah bagi loghat Cina dan Nigeria dengan menyifatkan pertuturan sebagai tidak jelas atau sukar difahami. Namun, para penyelidik mendapati sistem itu sangat baik menukar rakaman tersebut kepada teks bertulis yang tepat.
Ahia menghuraikan percanggahan antara kritikan model dengan prestasi transkripsinya:
Walaupun model berulang kali mendakwa penutur Cina dan Nigeria 'bercakap tidak jelas' atau 'sukar difahami', model sebenarnya sangat baik mentranskripsikan pertuturan berloghat itu.
Transkripsi bermaksud menulis perkataan yang diucapkan seseorang. Apabila sistem merekodkan jawapan dengan tepat tetapi mengkritiknya sebagai sukar difahami, penjelasannya wajar diteliti. Dalam kes ini, para penyelidik mengaitkan percanggahan itu dengan kecenderungan model yang kelihatan mengutamakan loghat tertentu.
Markah kandungan menjadikan masalah ini lebih serius. Seseorang penutur boleh kehilangan markah dua kali: pertama bagi penyampaian, kemudian bagi mutu jawapan yang perkataannya tidak berubah. Dalam temu duga, jawapan yang sama boleh kelihatan lebih lemah hanya kerana suara yang menyampaikannya.
Kecenderungan mengutamakan bahasa Inggeris Amerika
Pasukan itu turut menganalisis ciri akustik, iaitu sifat bunyi pertuturan yang boleh diukur. Para penyelidik mengira "jarak akustik" sesuatu loghat daripada bahasa Inggeris Amerika, iaitu sejauh mana corak bunyinya berbeza daripada rujukan tersebut.
Dalam perbandingan ini, loghat Cina dan Nigeria paling jauh daripada asas bahasa Inggeris Amerika. Loghat British dan India pula lebih hampir. Markah sering menurun apabila jarak yang diukur meningkat, sekali gus mengaitkan corak pemarkahan dengan perbezaan bunyi.
Para penyelidik mengemukakan beberapa kemungkinan penjelasan. Bahan latihan mungkin menggambarkan sesetengah loghat sebagai sukar difahami, mengandungi terlalu sedikit contoh daripada penutur tertentu, atau mengutamakan jangkaan lazim tentang cara seorang profesional sepatutnya bertutur.
Penjelasan itu masih berupa kemungkinan yang dikemukakan pasukan berkenaan. Namun, kebimbangan praktikalnya jelas: model yang dilatih dengan contoh tidak seimbang boleh membawa kecenderungan itu ke dalam penilaian, walaupun arahannya meminta jawapan dinilai secara adil.
Bahasa Inggeris ialah bahasa rasmi Nigeria dan digunakan sebagai bahasa pengantar di sekolah-sekolah India. Namun, penutur dari kedua-dua negara itu menerima penilaian lebih rendah berbanding penutur Amerika dan British dalam kajian tersebut. Penggunaan bahasa Inggeris sejak sekian lama di sesebuah negara tidak menjamin layanan setara daripada model-model ini.
Skop ujian dan kepentingannya
Eksperimen itu menilai model AI serba guna, bukannya produk pemarkahan sebenar yang dikendalikan platform pengambilan pekerja atau penyedia ujian bahasa Inggeris. Syarikat boleh membina aplikasi menggunakan model sedemikian, tetapi sistem penilaian komersial mempunyai reka bentuk dan prosedur tersendiri.
Bagi pemohon kerja, kebimbangannya ialah proses pemarkahan yang mungkin menghukum bunyi jawapan selain isinya. Bagi pelajar, masalah serupa boleh menjejaskan pembentangan lisan atau peperiksaan. Penyelidikan ini memberi tumpuan kepada cara penilaian sedemikian dibuat sebelum ia membantu menentukan peluang seseorang.
Ujian bahasa Inggeris juga dijalankan pada skala besar. PTE Academic kendalian Pearson, yang menggunakan AI untuk menilai sesetengah jawapan lisan dan digunakan bagi urusan visa serta imigresen, diduduki kira-kira 1.2 juta kali pada 2023, menurut angka yang dipetik dalam kertas kajian itu.
PTE Academic bukan antara produk yang dikaji. Sebaliknya, para penyelidik menggunakan contoh itu untuk menggambarkan jangkauan penilaian pertuturan automatik. Penulis kertas kajian itu berkata mereka tidak mengetahui sebarang audit awam terhadap ujian bahasa Inggeris yang dinilai AI, manakala cara sistem komersial beroperasi lazimnya tidak didedahkan kepada umum.
Google dan OpenAI membiayai sebahagian penyelidikan itu melalui sumbangan, walaupun model mereka antara yang diuji. Hubungan pembiayaan tersebut merupakan sebahagian daripada konteks kajian yang meneliti sistem keluaran syarikat berkenaan.
Garis masa penerbitan kajian
Penyelidikan itu diterbitkan dengan tajuk "The Cost of Sounding Different: Accent Bias in Audio Language Models." DOI yang disenaraikan ialah 10.18653/2026.emnlp-main.1612, dan kajian itu merupakan sebahagian daripada prosiding Persidangan 2026 mengenai Kaedah Empirikal dalam Pemprosesan Bahasa Semula Jadi.
Tarikh-tarikh itu menunjukkan pembentangan persidangan berlangsung sebelum pengumuman lebih meluas pada November:
- 25 Oktober 2026: Pasukan itu membentangkan penyelidikan di EMNLP di Budapest, Hungary.
- 5 November 2026: Dapatan itu diumumkan kepada umum dalam laporan yang menghuraikan lima kumpulan loghat, empat model dan pengesahan menggunakan 52 penutur manusia.
Dua peringkat ujian menjadi teras kepada dapatan tersebut. Suara yang dijana membolehkan para penyelidik mengekalkan teks yang sama merentas banyak contoh. Rakaman manusia kemudian menunjukkan kecenderungan umum yang sama, dengan jurang lebih besar antara loghat.
Perubahan yang diminta penyelidik daripada pembangun
Tsvetkov menggesa penggunaan data latihan dan penilaian yang lebih mewakili golongan yang akan menggunakan sistem pertuturan. Pasukan itu juga menggesa pembangun menerbitkan keputusan bagi pelbagai populasi dan dialek, dan bukannya bergantung pada satu markah purata sahaja.
Purata menggabungkan keputusan semua orang menjadi satu angka. Jika sistem berfungsi dengan baik bagi kumpulan besar tetapi lemah bagi kumpulan lebih kecil, angka gabungan itu boleh menyukarkan pengalaman kumpulan kecil untuk dilihat.
Tsvetkov menggunakan perbandingan hipotetikal untuk menjelaskan kebimbangan itu:
Kami tidak mahu ketepatan prestasi purata bagi populasi umum mencapai 97%, tetapi hanya 20% bagi kumpulan yang lebih kecil.
Para penyelidik merancang untuk mengkaji lebih banyak loghat manusia, termasuk variasi wilayah dalam sesebuah negara. Mereka juga bercadang menyiasat aplikasi audio dalam bidang perubatan, termasuk tindak balas kecemasan automatik, yang mana cara sistem mengendalikan pertuturan pemanggil boleh membawa kesan serta-merta.
Bagi pengambilan pekerja dan penilaian bahasa Inggeris, saranan mereka ialah menguji keadilan terhadap loghat secara langsung. Penilaian perlu meneliti sama ada orang menerima layanan setara merentas loghat, sama ada penilaian kandungan kekal tertumpu pada kandungan, dan sama ada alasan yang diberikan sistem sepadan dengan keupayaannya memahami rakaman.
Perkara Utama
- Empat model AI secara umumnya meletakkan loghat Amerika dan British di tempat tertinggi, loghat India di tengah-tengah, serta loghat Cina dan Nigeria di tempat terendah.
- Sesetengah markah kandungan berubah walaupun penutur menyampaikan perkataan yang sama.
- Ujian terhadap 52 penutur manusia menghasilkan jurang antara loghat yang lebih besar berbanding ujian menggunakan suara yang dijana.
- Model-model itu mentranskripsikan dengan tepat pertuturan yang kadangkala disifatkannya sebagai tidak jelas.
- Kajian itu meneliti model serba guna, bukannya produk komersial untuk pengambilan pekerja atau ujian bahasa Inggeris.
- Para penyelidik menggesa penerbitan penilaian merentas loghat dan merancang kajian lanjut tentang pertuturan wilayah serta audio perubatan.