GPU berfungsi dan dakwaan daya pemprosesan 5%
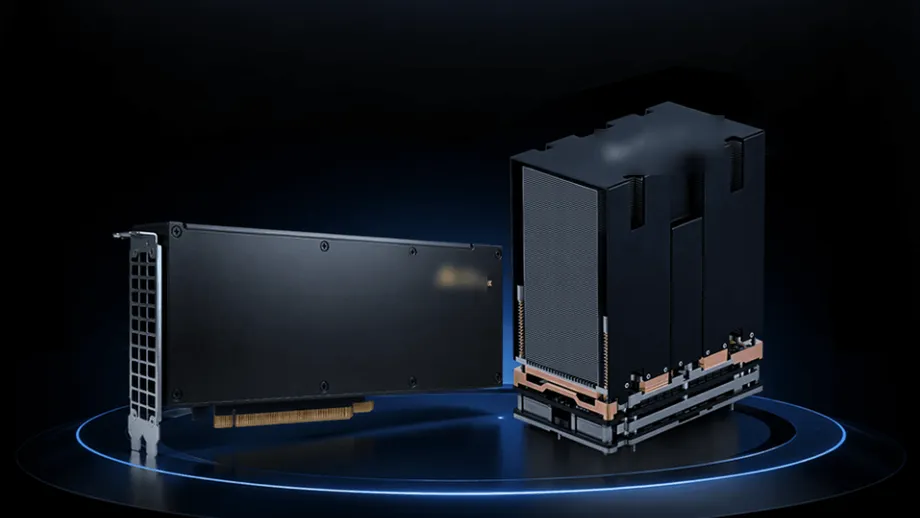
Iluvatar CoreX telah memperagakan pemproses grafik Tiangai 300 secara terbuka di Shanghai, mengetengahkan alternatif China kepada H200 Nvidia dengan dakwaan kelebihan 5% dalam ujian inferens pihak ketiga. Pada hari terbuka media syarikat itu pada 28 Oktober 2026, ia turut memperlihatkan sistem latihan lapan GPU serta menerangkan rak yang menempatkan 144 GPU dan 18 CPU.
Kandungan
- GPU berfungsi dan dakwaan daya pemprosesan 5%
- Perkara yang diukur dalam perbandingan H200
- Dokumen panjang dan respons awal yang lebih pantas
- Keputusan latihan menggunakan rujukan Nvidia yang berbeza
- Daripada pelancaran Julai kepada demonstrasi Oktober
- Rak yang dibina untuk 144 GPU
- Perkongsian kerja AI antara cip berlainan
- Dakwaan perisian menyasarkan masa pelaksanaan
- TY1200 meluaskan tumpuan kepada robot
- Perkara Utama
Perbandingan utama itu berdasarkan ujian yang diselesaikan Shanghai Electric Group pada Julai, menurut Iluvatar CoreX. Dalam pelaksanaan yang mengasingkan dua peringkat pemprosesan model bahasa besar, Tiangai 300 mencapai daya pemprosesan hujung ke hujung bersamaan 1.05 kali H200 selepas keputusan ditukar kepada angka bagi setiap kad.
Daya pemprosesan merujuk kepada jumlah kerja berguna yang diselesaikan sistem dalam tempoh tertentu. Bagi chatbot, ini boleh bermakna bilangan teks yang dijana setiap saat. Keputusan 1.05 kali prestasi rujukan bermakna output 5% lebih banyak dalam keadaan ujian tersebut.
Syarikat itu menyifatkan Tiangai 300 sebagai GPU serba guna China pertama yang mencapai prestasi H200 dalam ujian terukur. Demonstrasi Oktober itu memperluas perbandingan kepada model bahasa, penjanaan imej dan penjanaan video, manakala demonstrasi latihan berasingan menggunakan H100 Nvidia sebagai rujukan.
Acara itu merangkumi lebih daripada spesifikasi cip. Iluvatar CoreX mempersembahkan kad, pelayan, reka bentuk rak berketumpatan tinggi, alat perisian dan kaedah untuk berkongsi kerja AI antara pelbagai jenis pemproses. Hujah komersialnya ialah gabungan ini boleh menghasilkan output AI berguna dengan kos lebih rendah dan masa menunggu lebih singkat.
Perkara yang diukur dalam perbandingan H200
Ujian Shanghai Electric Group pada Julai menggunakan pengasingan praisi dan penyahkodan, yang sering diringkaskan sebagai pengasingan PD. Praisi ialah peringkat apabila model bahasa membaca permintaan pengguna dan bahan sokongannya. Penyahkodan pula ialah peringkat apabila model menjana jawapan, satu token pada satu masa. Token ialah unit kecil yang digunakan sistem AI untuk membahagikan teks.
Pengasingan peringkat ini membolehkan sistem menetapkan sumber secara berbeza untuk proses membaca dan menulis. Oleh itu, keputusan Tiangai 300 berkaitan dengan susunan pelaksanaan tertentu, dengan prestasi keseluruhan dinyatakan sebagai angka setara bagi satu kad.
Iluvatar CoreX belum menerbitkan kaedah ujian terperinci, senarai model atau keadaan beban kerja di sebalik keputusan utama pihak ketiga itu. Butiran tersebut, bersama pengiraan penukaran dan tetapan perisian, diperlukan untuk penghasilan semula secara bebas. Perbandingan kos juga belum disertakan pecahan yang diterbitkan, manakala angka memori bagi setiap kad dan keseluruhan rak memerlukan penjelasan.
Demonstrasi yang dinamakan oleh makmal prestasi itu memberikan gambaran lebih terperinci tentang dakwaan syarikat. Ia menunjukkan peningkatan berbeza bagi tugas berlainan, daripada peningkatan kecil dalam penjanaan multimedia hingga lonjakan lebih besar dalam daya pemprosesan pengesyoran. Bagi pembeli, perbandingan yang relevan ialah tugas yang benar-benar dijalankan oleh perkhidmatan mereka.
Dokumen panjang dan respons awal yang lebih pantas
Prestasi perhatian Tiangai 300 mencapai 1.05 kali prestasi H200 pada panjang konteks 64K, menurut makmal syarikat. Perhatian ialah proses yang membantu model menentukan bahagian input yang saling berkaitan. Panjang konteks 64K bermakna model memproses kira-kira 64,000 token.
Bagi GLM-5.3 pada skala konteks yang sama, Iluvatar CoreX mendakwa daya pemprosesan 1.15 kali prestasi H200 sambil mengekalkan pengalaman pengguna yang setara. Ini merupakan peningkatan 15% untuk beban kerja campuran pakar yang diuji. Model campuran pakar mengarahkan kerja kepada rangkaian pakar terpilih, bukannya menggunakan semua rangkaian untuk setiap token.
Bagi beban kerja ejen AI dengan konteks antara 8K hingga 128K, syarikat itu melaporkan pengurangan kira-kira 10% hingga 30% dalam masa menunggu token output pertama. Ukuran ini penting bagi seseorang yang menunggu pembantu mula menjawab selepas membaca dokumen panjang atau memproses permintaan rumit.
Penjanaan imej dan video turut menjadi sebahagian daripada demonstrasi. Syarikat itu melaporkan peningkatan kira-kira 2% hingga 5% dalam daya pemprosesan penjanaan multimodal berbanding H200. Bagi beban kerja carian dalam talian, pengiklanan dan pengesyoran, ia mendakwa daya pemprosesan inferens pengesyoran 21% lebih tinggi serta kependaman pengiraan ringan 26% lebih rendah.
Keputusan latihan menggunakan rujukan Nvidia yang berbeza
Demonstrasi latihan menggunakan Qwen3-32B, model dengan kira-kira 32 bilion parameter, pada pelayan lapan GPU. Parameter ialah nilai berangka yang dilaraskan oleh model semasa latihan untuk mempelajari corak. Iluvatar CoreX berkata daya pemprosesan berkesan bagi setiap kad mencapai 1.33 kali prestasi H100 Nvidia.
Oleh itu, kelebihan yang dilaporkan ialah 33% bagi demonstrasi latihan tersebut, dengan H100 sebagai cip perbandingan. Keputusan inferens lain yang dipersembahkan pada acara itu menggunakan H200. Membezakan produk rujukan ini penting untuk memahami angka tersebut.
Sistem latihan itu beroperasi pada ketepatan FP8. FP8 menyimpan nombor menggunakan lapan bit, sekali gus mengurangkan jumlah data yang perlu dipindahkan dan diproses berbanding format yang menggunakan lebih banyak bit. Perisian latihan AI perlu mengurus ketepatan lebih rendah ini dengan cermat bagi mengekalkan mutu pembelajaran.
Iluvatar CoreX turut melaporkan variasi masa langkah sebanyak 0.43% semasa operasi berpanjangan pada beban penuh, berbanding 0.76% bagi sistem rujukan berasaskan Hopper. Masa langkah ialah tempoh yang diperlukan untuk menyelesaikan satu unit kerja berulang. Masa yang lebih konsisten boleh membantu pengendali menganggarkan jumlah kerja yang dapat diselesaikan oleh sistem sibuk.
Daripada pelancaran Julai kepada demonstrasi Oktober
Tiangai 300 diperkenalkan secara rasmi pada Persidangan Kecerdasan Buatan Dunia pada Julai 2026. Ia menggunakan seni bina Tianshu syarikat, menggabungkan Tensor Core generasi baharu dan dilengkapi memori grafik 144GB.
Pemproses itu menyokong operasi skalar, vektor dan tensor. Secara ringkas, operasi ini mengendalikan nombor individu, kumpulan nombor dan tatasusunan matematik yang lebih besar. Format angka yang disokong termasuk FP4, FP8, FP16 dan BF16, memberikan pembangun perisian pilihan berbeza dari segi kelajuan, penggunaan memori dan ketepatan angka.
Pencapaian penting yang diumumkan syarikat itu merangkumi beberapa bulan:
- Julai 2026: Tiangai 300 dilancarkan pada Persidangan Kecerdasan Buatan Dunia.
- Julai 2026: Shanghai Electric Group menyelesaikan ujian pihak ketiga yang dirujuk bagi perbandingan daya pemprosesan dengan H200.
- Sebelum acara media Oktober: reka bentuk rak IXL144 diperlihatkan di Pameran Industri Antarabangsa China.
- 28 Oktober 2026: Iluvatar CoreX membuka demonstrasi perkakasan Tiangai 300 secara langsung kepada media di Shanghai.
Acara Oktober mengalihkan tumpuan kisah produk daripada pembentangan seni bina kepada sistem yang menjalankan beban kerja tertentu. Julat pelaksanaan yang diterangkan syarikat kini merangkumi kad pemecut individu, pelayan dengan lapan kad dan sistem IXL144 yang lebih besar.
Rak yang dibina untuk 144 GPU
IXL144 menggabungkan 144 GPU dan 18 CPU dalam satu rak standard, dengan kira-kira 10.1TB memori GPU terkumpul, menurut Iluvatar CoreX. Syarikat itu menyifatkannya sebagai supernod GPU paling padat dalam industri yang ditempatkan dalam satu rak. Supernod menghubungkan banyak pemproses secara rapat supaya semuanya dapat bekerjasama untuk tugasan besar.
Spesifikasi 144GB bagi setiap Tiangai 300 yang dinyatakan dan jumlah 10.1TB bagi rak memerlukan pecahan konfigurasi yang lebih jelas. Pendaraban 144 kad dengan 144GB memberikan 20,736GB, sebelum mengambil kira perbezaan cara kapasiti dikira. Penerangan rak itu perlu menyatakan konfigurasi kad dan kapasiti memori yang tersedia untuk beban kerja.
Iluvatar CoreX menganggarkan sistem itu boleh mengurangkan kos bagi setiap sejuta token berkesan kira-kira 40% berbanding sistem antarabangsa arus perdana. Token berkesan merujuk kepada output yang dikira sebagai kerja berguna. Bagi pengendali yang menjual perkhidmatan AI, ukuran ini mengaitkan perbelanjaan perkakasan dengan jumlah output berguna yang dihasilkan.
Pengurangan 40% bermakna kos 60 unit bagi kerja yang berharga 100 unit pada sistem rujukan. Penjimatan sebenar bergantung pada harga peralatan, penggunaan kuasa, perisian, beban kerja dan sejauh mana GPU digunakan secara konsisten.
Syarikat itu turut menyatakan sasaran bagi enjin saling sambung rakan ke rakan generasi seterusnya: mengurangkan pemindahan tunggal dalam domain tersambung daripada 3 hingga 5 mikrosaat kepada 1 mikrosaat. Komunikasi lebih pantas membantu apabila GPU berbeza menyimpan bahagian berlainan model dan perlu bertukar data berulang kali.
Perkongsian kerja AI antara cip berlainan
Pendekatan pelaksanaan heterogen Iluvatar CoreX menetapkan bahagian inferens yang berlainan kepada jenis pemproses yang berlainan. Di bawah skema pengasingan AFD, Tiangai 300 mengendalikan keseluruhan peringkat praisi dan pengiraan perhatian semasa penyahkodan. XPU rakan kongsi mengendalikan rangkaian pakar suapan hadapan.
XPU ialah istilah umum bagi jenis pemecut pengkomputeran yang lain. Idea asasnya ialah memberikan setiap pemproses kerja yang paling sesuai dilaksanakannya, sementara penjadual bersama menyelaraskan keseluruhan tugasan. Rangkaian suapan hadapan menjalankan satu lagi bahagian utama pemprosesan matematik dalam model bahasa.
Syarikat itu melaporkan pengurangan 60% dalam kependaman inferens penyahkodan di bawah penjadualan bersatu. Ini ialah konfigurasi sistem yang berbeza daripada kelebihan daya pemprosesan utama 5% berbanding H200, dan menggunakan ukuran prestasi yang berlainan.
Shan Tianyi, ketua AI dan pengkomputeran dipercepat syarikat itu, berkata sistem pengkomputeran AI masa depan bergantung pada penyusunan cip berlainan secara cekap, bukannya bergantung pada satu jenis pemproses untuk setiap tugas. Demonstrasi AFD menterjemahkan strategi itu kepada susunan konkrit yang menggabungkan GPU dan pemecut rakan kongsi.
Dakwaan perisian menyasarkan masa pelaksanaan
Iluvatar CoreX turut mempersembahkan timbunan perisian AI untuk AI yang bertujuan mengautomatikkan sebahagian proses pelaksanaan dan pengoptimuman. Syarikat itu berkata tugas menyediakan persekitaran dipendekkan daripada satu jam kepada 10 minit, manakala bilangan operasi manual dikurangkan daripada berpuluh-puluh kepada satu.
Bagi satu tugas pengoptimuman model besar, syarikat itu melaporkan pemendekan kitaran kerja daripada tujuh hari kepada kurang dua jam, dengan prestasi menghampiri dua kali tahap sebelumnya. Contoh ini berkaitan dengan kerja kejuruteraan yang diperlukan untuk menjalankan model dengan cekap pada perkakasan.
Syarikat itu turut mendakwa integrasi mendalam dengan FlyDSL, bahasa yang digunakan untuk membangunkan rutin pengiraan GPU. Ia berkata kelajuan kompilasi meningkat lebih 90% dan menerangkan bahawa aliran kerja yang sebelum ini memerlukan 10 orang bekerja selama sehari kini diselesaikan oleh seorang dalam beberapa jam.
Sokongan perisian penting kerana pemproses memerlukan lebih daripada perkakasan pengiraan yang berupaya. Model, pustaka matematik dan alat pelaksanaan perlu berfungsi bersama. Demonstrasi perisian itu menunjukkan jumlah usaha kejuruteraan yang mungkin diperlukan pelanggan sebelum dapat menjadikan GPU baharu sebagai perkhidmatan yang berfungsi.
TY1200 meluaskan tumpuan kepada robot
Acara di Shanghai itu turut menampilkan Tongyang TY1200, pemproses berasingan yang menyasarkan PC AI dan kecerdasan terjelma, termasuk robot yang mengesan keadaan dan bertindak dalam dunia fizikal. Keupayaan pengiraan padat yang dinyatakan ialah 300 TOPS, atau 300 trilion operasi sesaat. Pengiraan padat mengira kerja tanpa bergantung pada pengiraan yang dilangkau melibatkan nilai sifar.
Iluvatar CoreX mendakwa TY1200 mencapai 1.2 kali prestasi Nvidia Thor T5000 dalam ujian menggunakan Qwen3.8-27B dan Qwen3.6-35B-A3B. Bagi model Cosmos-R2-2B dan Cosmos-R2-8B dalam senario AI fizikal, syarikat itu melaporkan prestasi masing-masing bersamaan 158% dan 180% daripada rujukan Thor T5000.
Syarikat itu turut berkata TY1200 boleh menjalankan simulasi fizik dipercepat GPU menggunakan MuJoCo-Warp. Ini membolehkan sistem pembangunan robot mensimulasikan pergerakan, melatih dasar kawalan dan menyemak tindakan secara setempat. Dasar kawalan ialah set arahan yang dipelajari dan digunakan robot untuk menentukan cara bergerak.
Aplikasi yang dilaporkan termasuk robot yang membantu orang ramai semasa lawatan perubatan, penglihatan industri dan panduan pengunjung. Pengganti yang dirancang, TY2000, mempunyai sasaran pengiraan 600T. Bersama-sama, produk ini meluaskan strategi syarikat daripada pelayan AI berskala besar kepada peralatan yang beroperasi dekat dengan pengguna dan mesin.
Perkara Utama
- Iluvatar CoreX memperagakan perkakasan Tiangai 300 di Shanghai pada 28 Oktober 2026.
- Syarikat itu merujuk kepada ujian Shanghai Electric Group yang menunjukkan daya pemprosesan setiap kad bersamaan 1.05 kali prestasi Nvidia H200.
- Demonstrasi latihan Qwen3-32B menggunakan lapan GPU dilaporkan mencapai daya pemprosesan setiap kad sebanyak 1.33 kali H100 pada ketepatan FP8.
- Kaedah terperinci di sebalik penanda aras utama pihak ketiga itu belum diterbitkan.
- Rak IXL144 mengandungi 144 GPU dan 18 CPU, dengan dakwaan pengurangan 40% dalam kos bagi setiap sejuta token berkesan.
- Pelaksanaan berasingan yang berkongsi kerja antara GPU dan XPU dilaporkan mengurangkan kependaman penyahkodan sebanyak 60%.
- Acara itu turut mengetengahkan automasi perisian serta aplikasi TY1200 dalam AI setempat dan simulasi robotik.