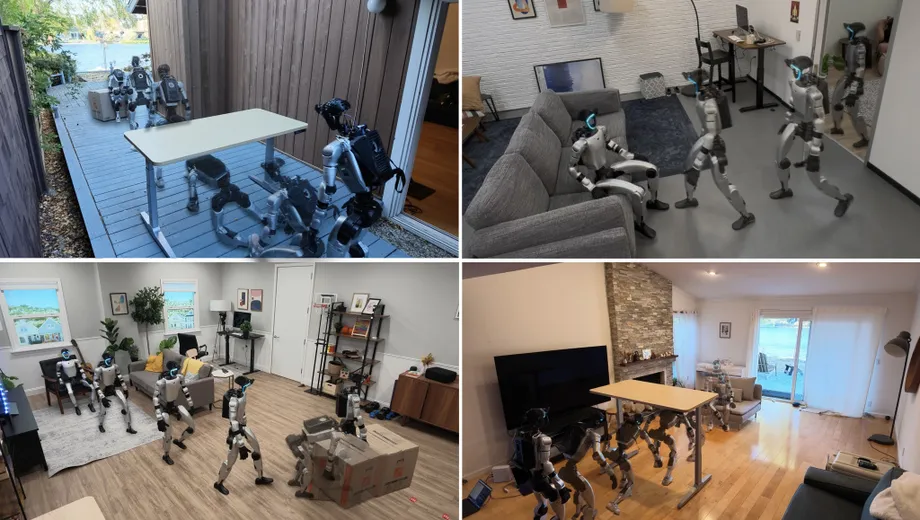
Robot yang dilatih di rumah maya menghadapi ruang sebenar
Penyelidik Apple berkata sistem kawalan humanoid HALO mereka menyelesaikan tugasan fizikal secara individu dengan kadar kejayaan purata 91% dalam 360 percubaan merentasi enam persekitaran sebenar yang tidak pernah diimbas atau dipetakan untuknya. Beroperasi pada Unitree Robotics G1, sistem itu menggunakan hasil pembelajaran dalam simulasi untuk bergerak di ruang yang tidak dikenali, duduk di atas perabot, melalui bukaan sempit dan menolak kotak.
Kandungan
- Robot yang dilatih di rumah maya menghadapi ruang sebenar
- Skop hasil 91%
- Mengapa arahan lebih panjang lebih sukar
- Tiga lapisan menterjemah arahan kepada pergerakan
- Mac mini dibawa pada G1
- Bagaimana 1,000 rumah maya membekalkan contoh latihan
- Kos pengkomputeran dan kerja manusia
- Penglihatan masih belum menyelesaikan masalah sentuhan
- Perubahan yang dibawa oleh kajian ini
- Perkara Utama
Hasil kajian itu dimuatkan dalam Perceptive Humanoid Motion from Simulation, yang dihantar kepada arXiv pada 4 November 2026. Makalah pasukan Apple itu menerangkan latihan menggunakan kira-kira 300 jam contoh sintetik merentasi 1,000 persekitaran rumah yang dijana komputer, sebelum sistem itu dipindahkan secara langsung kepada robot fizikal.
Tugasan yang lebih panjang lebih sukar. Dalam satu persekitaran sebenar yang berasingan, HALO mencatat purata kejayaan 70% bagi tiga gabungan tindakan, setiap satunya diuji sebanyak 10 kali. Urutan yang memerlukan robot itu menunduk di bawah halangan, menghampiri sasaran dan menolak kotak berjaya dalam lima daripada 10 percubaan.
Kemajuan praktikalnya ialah hubungan antara memahami arahan dengan menggerakkan seluruh badan melalui ruang yang dipenuhi perabot yang tidak dikenali. Arahan seperti duduk di kerusi memerlukan robot mengenal pasti tempat duduk, mencari laluan, mengatur kedudukan badan dan mengekalkan keseimbangan ketika menurunkan badan. HALO membahagikan tanggungjawab tersebut kepada tiga lapisan kawalan yang bekerjasama.
Penulisnya ialah Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller dan Vladlen Koltun, semuanya disenaraikan dengan afiliasi Apple. Mereka turut mengeluarkan kod yang merangkumi penjanaan data, latihan dan pelaksanaan, termasuk perancangan tugasan, penjanaan gerakan dan penjejakan gerakan dalam simulasi serta pada robot fizikal.
Skop hasil 91%
Enam kemahiran individu itu mencatat kadar kejayaan yang berbeza. Perbuatan mencangkung menunjukkan prestasi terbaik, manakala duduk merupakan tindakan yang paling kurang berjaya antara tindakan yang diuji:
- Bergerak ke objek yang dinamakan: 92%.
- Duduk di atas perabot: 85%.
- Melalui pintu yang terbuka sebahagian: 93%.
- Mencangkung di bawah halangan: 100%.
- Merangkak di bawah halangan: 90%.
- Menolak kotak: 88%.
Jurang antara mencangkung dengan duduk ialah 15 mata peratusan. Duduk bukan sekadar sampai ke tempat yang betul: robot perlu menyelaraskan kedudukan dengan perabot dan memindahkan berat badannya ke tempat duduk. Ini menuntut keupayaan pemahaman visual serta pengawal fizikalnya.
Kesemua enam persekitaran penilaian tidak dikenali HALO. Penyelidik tidak mengimbasnya terlebih dahulu atau menggunakannya semasa latihan. Makalah itu menyifatkannya sebagai pemindahan sifar pukulan, bermaksud sistem beralih daripada latihan simulasi kepada persekitaran fizikal tersebut tanpa latihan tambahan bagi setiap lokasi.
Demonstrasi turut menunjukkan G1 mengikuti seseorang, duduk di sofa, bergerak mengiring melalui pintu yang terbuka sebahagian serta menunduk atau merangkak di bawah meja. Pergerakan ini menggambarkan cara sistem menyesuaikan posturnya dengan ruang di sekeliling, bukannya sekadar berjalan menuju destinasi.
Mengapa arahan lebih panjang lebih sukar
Tiga gabungan tugasan HALO menghasilkan julat keputusan yang lebih luas. Melalui pintu kemudian bergerak ke sasaran berjaya dalam kesemua 10 percubaan. Mencangkung kemudian duduk berjaya dalam enam percubaan. Mencangkung, menghampiri sasaran dan menolak kotak berjaya dalam lima percubaan.
Secara keseluruhan, keputusan itu bersamaan 21 urutan berjaya daripada 30 percubaan, atau 70%. Angka itu 21 mata peratusan lebih rendah daripada purata tugasan individu, walaupun urutan tersebut diuji dalam persekitaran berbeza dan dengan bilangan percubaan yang lebih sedikit.
Urutan tindakan membuka lebih banyak ruang untuk masalah kerana hasil satu pergerakan menjadi kedudukan permulaan bagi pergerakan seterusnya. Contohnya, selepas keluar dari bawah halangan, robot perlu berada dalam kedudukan yang membolehkannya menghampiri sasaran dan melakukan pergerakan seterusnya.
HALO menanganinya melalui semakan visual. Perancangnya memerhatikan video dari perspektif robot, menilai sama ada tindakan semasa berjaya dan memutuskan sama ada hendak meneruskan atau mencuba semula. Hasilnya menunjukkan bahawa menghubungkan kemahiran yang berguna masih lebih mencabar berbanding melakukannya secara berasingan.
Tiga lapisan menterjemah arahan kepada pergerakan
Lapisan kawalan tertinggi mengendalikan perancangan tugasan. Ia menggunakan model bahasa-penglihatan, sejenis AI yang memproses imej dan perkataan, untuk mentafsir arahan bersama-sama dengan perkara yang dilihat kamera. Model lalai ialah Qwen3.6-35B-A3B, yang dijalankan secara setempat pada Mac mini yang dibawa oleh robot.
Perancang itu diaktifkan setiap dua saat. Jika seseorang meminta robot duduk tanpa menamakan tempat duduk, robot perlu memilih objek yang sesuai dalam pandangan. Jika meja menghalang laluan ke kerusi, robot boleh memecahkan arahan itu kepada tindakan lebih kecil: menunduk di bawah halangan, menghampiri kerusi dan duduk.
Lapisan tengah menukarkan setiap subtugasan kepada pelan pergerakan. Ia menggabungkan Qwen3.5-2B, yang parameter pengekodnya kekal tetap semasa latihan, dengan penyahkod pengubah resapan yang menjana gerakan seluruh badan. Pengekod menukarkan imej dan arahan kepada perwakilan yang boleh digunakan oleh model pergerakan; penyahkod pula menghasilkan pose yang dirancang.
Lapisan ini melihat kira-kira lima saat ke hadapan dan merancang semula sekitar tiga kali sesaat. Oleh itu, ia terus mengemas kini pergerakan yang dirancang berdasarkan pemerhatian kamera baharu, bukannya menetapkan tindakan lima saat penuh tanpa memeriksa persekitaran.
Lapisan paling bawah, yang dipanggil penjejak gerakan, menukarkan pelan tersebut kepada arahan sendi sebanyak 50 kali sesaat. Ia menggabungkan imej kedalaman dengan maklumat tentang kedudukan dan pergerakan robot itu sendiri, sekali gus membantunya mengikuti pelan sambil mengambil kira keseimbangan, sentuhan dan had motor.
Mac mini dibawa pada G1
Persediaan fizikal itu meletakkan Mac mini dengan cip M4 Pro dan memori bersatu 64 GB di dalam kepungan pelindung pada belakang G1. Komputer itu menjalankan model perancangan tugasan dan penjanaan gerakan yang lebih mencabar. Pemproses terbina dalam G1 pula menjalankan penjejak gerakan.
Tapak kepala tersuai membawa kamera OAK-1W. Strim video warnanya mempunyai resolusi 1280 kali 800 piksel, beroperasi pada 30 bingkai sesaat dan meliputi medan pandangan 120 darjah. Pandangan luas itu membantu sistem memerhatikan perabot dan bukaan berhampiran ketika badan bergerak.
Robot itu beroperasi tanpa sambungan berwayar, dengan komponen perisiannya berkomunikasi melalui ZeroMQ, iaitu sistem pemesejan. Konfigurasi setempat lalainya boleh berfungsi tanpa sambungan internet. HALO juga boleh menggunakan model awan melalui antara muka pengaturcaraan aplikasi jika dikonfigurasikan sedemikian.
Pembahagian kerja pengkomputeran ini sepadan dengan hierarki kawalan. Arahan boleh difahami dengan kekerapan yang lebih rendah, manakala mengekalkan kestabilan robot yang bergerak memerlukan kemas kini yang jauh lebih pantas. Penjana gerakan mengira pelan baharu sementara penjejak terus melaksanakan pelan semasa, sekali gus mengelakkan robot berhenti setiap kali model perlu membuat pengiraan.
Bagaimana 1,000 rumah maya membekalkan contoh latihan
Saluran latihan HALO menangani kekurangan khusus: contoh yang menghubungkan perkara yang dilihat humanoid, arahan yang diterimanya dan cara seluruh badannya patut bergerak. Video biasa mengandungi imej tindakan, tetapi latihan sistem ini memerlukan imej tersebut dipadankan dengan arahan dan gerakan robot yang terperinci.
Penulis menerangkan masa yang diperlukan oleh beberapa kaedah yang mengumpulkan demonstrasi melalui kendalian manusia atau peranti rakaman boleh pakai:
Oleh sebab seseorang perlu melakonkan setiap episod secara manual, sejam data memerlukan sekurang-kurangnya sejam masa manusia.
Sebaliknya, HALO membina contoh berpadanan dalam simulasi. Proses itu bermula dengan tugasan yang dibahagikan kepada segmen gerakan. Duduk di kerusi berlengan, misalnya, boleh melibatkan berjalan ke hadapan, berpusing dan menurunkan badan ke tempat duduk. Gesaan teks, titik laluan dan pose utama membimbing model penjanaan gerakan bernama Kimodo.
Pemeriksaan geometri automatik kemudian menilai gerakan calon untuk mengesan masalah seperti kaki tergelincir, badan menembusi lantai, lompatan mengejut dan sendi bergerak melepasi hadnya. Saluran itu mengekalkan calon terbaik sebelum meletakkan pergerakan tersebut di dalam bilik maya.
Infinigen, penjana pemandangan prosedural, menyediakan 1,000 persekitaran dengan susun atur dan perabot yang pelbagai, termasuk ruang tamu, pejabat dan bilik tidur. Sistem itu mencari kedudukan yang membolehkan pergerakan yang dirancang robot serta objek sasaran berada pada tempatnya tanpa berlanggar dengan perabot di sekeliling.
Simulator kemudian menghasilkan gambaran tentang perkara yang akan dilihat robot ketika melakukan tindakan itu, menggunakan kamera mata ikan simulasi yang dipadankan dengan persediaan fizikal. Perubahan pada pencahayaan, dedahan, warna, kontras, kabur dan hingar sensor menjadikan imej lebih pelbagai. Setiap contoh yang terhasil menghubungkan arahan, pandangan kamera dan pergerakan badan yang sepadan.
Kos pengkomputeran dan kerja manusia
Penjanaan korpus latihan utama mengambil kira-kira 48 jam menggunakan 250 pemproses grafik Nvidia H100. Pemproses ini, yang lazim dipanggil GPU, mengendalikan banyak pengiraan secara serentak, sekali gus membolehkan sejumlah besar data simulasi dihasilkan pada masa yang sama.
Penjana tindakan dilatih melalui pembelajaran peniruan menggunakan 64 GPU Nvidia B200. Dalam pembelajaran peniruan, model belajar menghasilkan semula tingkah laku contoh. Penjejak gerakan menggunakan empat GPU H100 untuk latihan yang menggabungkan pembelajaran pengukuhan dengan penyulingan dasar.
Pembelajaran pengukuhan melatih pengawal melalui percubaan dan maklum balas tentang prestasinya. Penyulingan dasar memindahkan tingkah laku yang dipelajari kepada model lain. Dalam HALO, kaedah ini membantu penjejak menukarkan pose yang dirancang kepada pergerakan yang boleh dilaksanakan oleh robot fizikal.
Manusia masih menentukan sebahagian daripada proses itu. Menambah tugasan fizikal baharu memerlukan penulisan gesaan dan reka bentuk pose utama, manakala sesetengah gerakan menggunakan video manusia atau bahan tangkapan gerakan. Setelah huraian dan kekangan tugasan itu tersedia, saluran tersebut boleh menggunakannya semula merentasi banyak bilik yang dijana.
Oleh itu, perubahan utamanya terletak pada cara demonstrasi diperbanyak. Daripada memerlukan seseorang melakukan setiap episod, HALO menggunakan sumber pengkomputeran untuk menjana dan menyemak banyak variasi sesuatu tugasan.
Penglihatan masih belum menyelesaikan masalah sentuhan
Menurut penyelidik, HALO kini bergantung terutamanya pada penglihatan dan tidak dapat mengesan sentuhan secara langsung. Prestasinya boleh merosot semasa tugasan yang melibatkan sentuhan fizikal ketara apabila objek terkeluar daripada pandangan kamera atau terlindung di sebalik objek lain.
Menolak kotak menunjukkan sebab perkara ini penting. Robot perlu memastikan kedudukan badannya betul berbanding kotak ketika kedua-duanya bergerak. Kamera boleh memberikan maklumat tentang kedudukan yang kelihatan, manakala pengesanan sentuhan boleh memberikan maklumat tentang sentuhan yang masih berguna apabila pandangan terhalang.
Penyelidik menyenaraikan pengesanan sentuhan sebagai salah satu kemungkinan hala tuju kajian seterusnya. Mereka tidak memberikan jadual masa untuk menambahkannya. Hasil semasa menetapkan batas yang jelas bagi cabaran itu: HALO boleh melaksanakan beberapa kemahiran berpandukan penglihatan di bilik yang tidak dikenali, manakala urutan lebih panjang dan interaksi yang melibatkan sentuhan masih kurang boleh diharap.
Perubahan yang dibawa oleh kajian ini
Kajian Apple menggabungkan penjanaan data latihan, perancangan berasaskan bahasa dan kawalan fizikal dalam satu sistem yang beroperasi pada humanoid di bilik yang belum pernah ditemuinya. Hasil terkuatnya ialah pemindahan daripada 1,000 persekitaran simulasi kepada 360 percubaan fizikal tanpa pemetaan awal bagi enam lokasi ujian.
Kod yang dikeluarkan menyediakan saluran itu untuk penyelidikan lanjut dalam simulasi dan perkakasan. Skopnya merangkumi mekanisme untuk menghasilkan contoh latihan serta model dan perisian yang diperlukan untuk menjana, menjejak dan menyelaraskan pergerakan.
Bagi seseorang yang meminta robot duduk atau mengalihkan kotak, kebolehpercayaan bergantung pada keseluruhan proses yang saling berhubung: mengenal pasti objek yang betul, mencapainya, membuat sentuhan dan menyelesaikan pergerakan. Keputusan tugasan individu HALO menunjukkan kemajuan dalam proses itu. Keputusan urutannya pula mengenal pasti bahagian yang masih perlu diperbaiki sebelum beberapa tindakan dapat digabungkan dengan tahap konsistensi yang sama.
Perkara Utama
- Penyelidik Apple menghantar Perceptive Humanoid Motion from Simulation kepada arXiv pada 4 November 2026.
- HALO mencapai kadar kejayaan purata 91% dalam 360 percubaan tugasan individu di enam persekitaran sebenar yang tidak dikenali dan belum dipetakan.
- Tiga gabungan tugasan mencatat purata kejayaan 70% dalam 30 percubaan di satu lagi persekitaran sebenar.
- Sistem itu menggabungkan perancangan tugasan, penjanaan gerakan dan penjejak yang mengeluarkan arahan sendi sebanyak 50 kali sesaat.
- Latihan menggunakan kira-kira 300 jam contoh sintetik merentasi 1,000 persekitaran yang dijana.
- Mac mini yang dibawa oleh Unitree G1 menyokong operasi setempat tanpa sambungan internet.
- Reka bentuk tugasan oleh manusia masih menjadi sebahagian daripada latihan, manakala keupayaan pengesanan sentuhan yang terhad masih menjadi kelemahan.